Depuis 2019, emagine accompagne d'importants constructeurs automobiles et éditeurs de logiciels dans la mise en place de la reconnaissance vocale embarquée, avec une équipe dédiée composée de linguistes informatiques, de développeurs et de data scientists.
Environ 50 % des conducteurs utilisent aujourd'hui des commandes vocales dans leur véhicule, pour piloter le système de navigation, lancer des playlists ou recevoir des actualités vocales. À l'instar du smart home, les assistants vocaux intégrés aux véhicules s'appuient sur des modèles linguistiques avancés et largement testés pour garantir une compréhension et une exécution précises des commandes vocales.
De la parole au texte, du code à l'action
Pour qu'un ordinateur embarqué comprenne et exécute correctement la reconnaissance vocale, il lui faut les bonnes données vocales et les bons modèles. Cela suppose de convertir les entrées vocales dans un format exploitable techniquement. Au fil de ce processus, la parole se transforme en commandes actionnables.
Les actions que le véhicule doit effectuer sont clairement définies — par exemple lancer un appel téléphonique, ajuster la climatisation ou se diriger vers une destination. Pour déclencher l'action « lancer un appel », un conducteur peut utiliser diverses commandes vocales comme « Appelle [personne abc] » ou « Lance un appel avec [personne abc] ».
Quelle que soit la formulation, la voiture est conçue pour exécuter l'action prévue. Ces différentes variantes d'énoncés sont également prédéfinies pour garantir une interaction fluide.
Étape 1 : la langue
Le processus orienté données démarre ensuite : les données linguistiques sont collectées, soit à travers des interactions parlées, soit traitées par des locuteurs natifs.
Cette compilation progressive donne naissance à des corpus complets, servant de modèles linguistiques ou de données, qui forment la base statistique. Chaque langue nécessite ses propres corpus, accompagnés de règles distinctes.
Étape 2 : le texte
Une conversion informatique transforme les enregistrements vocaux du format audio au format texte. Plus la diversité de variantes pour une commande est grande, plus la prise en charge de la commande vocale est robuste, ce qui se traduit par une exécution plus précise des actions souhaitées par le véhicule.
Au cours de cette étape, les données textuelles sont catégorisées et annotées avec des labels et mots-clés pertinents — par exemple, « appels » est mappé à « téléphone ». Ainsi, la commande est associée au bon sujet, ce qui optimise la compréhension et la réponse du système.
Étape 3 : le code
Vient ensuite la génération de codes et de scripts exploitables, via des langages de programmation largement utilisés comme Python et PowerShell. Le langage humain se transforme en langage machine, et les vastes volumes de données aboutissent à la création d'un modèle linguistique qui alimente la compréhension et la capacité de réponse du système.
Étape 4 : l'action
En s'appuyant sur les données stockées dans le code, le logiciel exécute la commande souhaitée exactement comme prévu. Dans notre exemple, le logiciel établit une liaison téléphonique (sans vidéo) avec l'interlocuteur indiqué « abc » (et non « xyz »), sans interruption, réalisant l'action prévue de manière fluide.
Que se passe-t-il ensuite ?
- Le conducteur énonce une phrase.
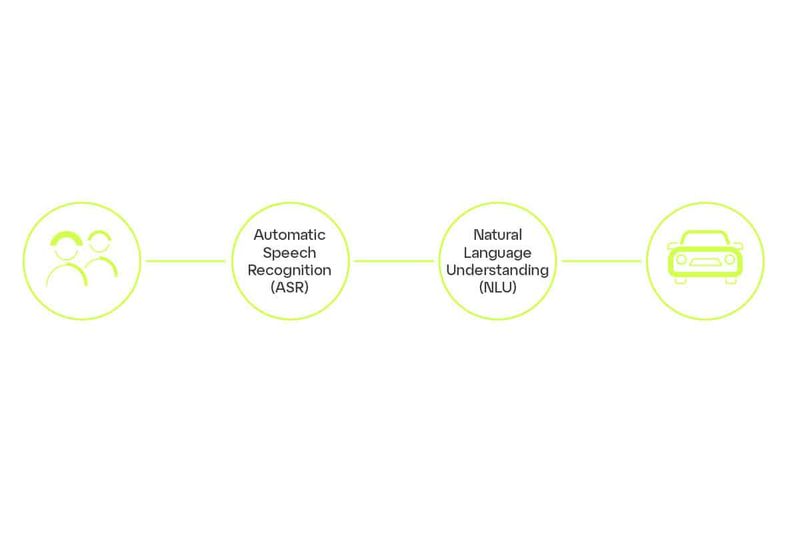
- L'Automatic Speech Recognition (ASR) reconnaît l'entrée vocale et la transcrit en texte.
- Le logiciel analyse ce texte et classifie le sujet en le comparant aux règles écrites pour chaque langue.
- Si la commande a été correctement attribuée, le système de gestion du dialogue (aussi appelé Human Machine Interface) réagit en activant la fonction (lance l'appel souhaité) ou en générant une réponse vocale (« Veuillez répéter la commande. »).
À l'instar du smart home, les assistants vocaux intégrés aux véhicules s'appuient sur des modèles linguistiques avancés et largement testés pour garantir une compréhension et une exécution précises des commandes vocales.
Modèles linguistiques d'emagine
Depuis 2019, nous conseillons et accompagnons des constructeurs automobiles et éditeurs de logiciels majeurs dans l'intégration de technologies vocales de pointe dans leurs véhicules. Grâce à une collaboration technique étroite avec les équipes de développement de nos clients, emagine a conçu l'ensemble des modèles vocaux des véhicules actuels du deuxième plus grand constructeur automobile mondial.
Par ailleurs, nous accompagnons avec fierté le leader mondial des logiciels de reconnaissance vocale. Le système fonctionne avec une efficacité quasi parfaite sur un éventail impressionnant de 17 langues.
Sous la direction experte d'un Technical Lead, notre équipe réunit des experts NLU/NLP, des linguistes informatiques, des spécialistes du machine learning, des data scientists et des locuteurs natifs, spécifiquement assemblés pour répondre aux besoins de nos clients.
Aujourd'hui, notre équipe maîtrise 17 des langues les plus utilisées au monde. emagine assume pleinement les dimensions commerciale et technique du projet, garantissant une responsabilité totale tout au long du processus.